AI 양자화: 4비트 모델을 쓰면 GPU 비용도 4분의 1일까?
모델을 16비트에서 4비트로 줄이면 서버 비용도 같은 비율로 내려갈까. 숫자만 보면 그럴듯하다. 하지만 가중치 파일의 크기, GPU에서 실제로 차지하는 메모리, 서비스를 운영하는 비용은 서로 다른 지표다. 이 셋을 한 숫자로 묶으면 작은 모델을 골랐는데도 기대한 절감이 나오지 않는 이유를 놓치게 된다.
1. 4비트가 먼저 줄이는 것은 가중치 저장공간이다
파라미터 하나를 저장하는 데 16비트 대신 4비트를 쓴다면, 가중치 데이터 자체는 이론상 4분의 1이다. 가상의 100억 파라미터를 모두 FP16으로 저장하면 단순 계산으로 약 20GB, 모두 4비트로 저장하면 약 5GB다. 여기서 GB는 10억 바이트 기준이며 실제 모델 용량을 측정한 값이 아니다.
양자화된 값에는 스케일 같은 보조 정보가 필요하고, 모든 모듈이 반드시 같은 정밀도로 바뀌는 것도 아니다. 일부 계층은 더 높은 정밀도로 남을 수 있다. 저장 형식과 그룹 크기도 영향을 준다. 따라서 “가중치가 5GB”를 “5GB GPU에서 바로 실행 가능”으로 읽으면 안 된다.
NVIDIA TensorRT 공식 문서는 해당 엔진의 INT4 지원을 가중치 중심 양자화인 weight-only quantization으로 설명한다. 이것은 그 구현의 지원 범위이지 모든 4비트 기술이 같은 방식이라는 뜻은 아니다. 사용하는 엔진이 무엇을 양자화하는지부터 구분해야 한다.
2. 실행 중 메모리에는 모델 밖의 비용도 붙는다
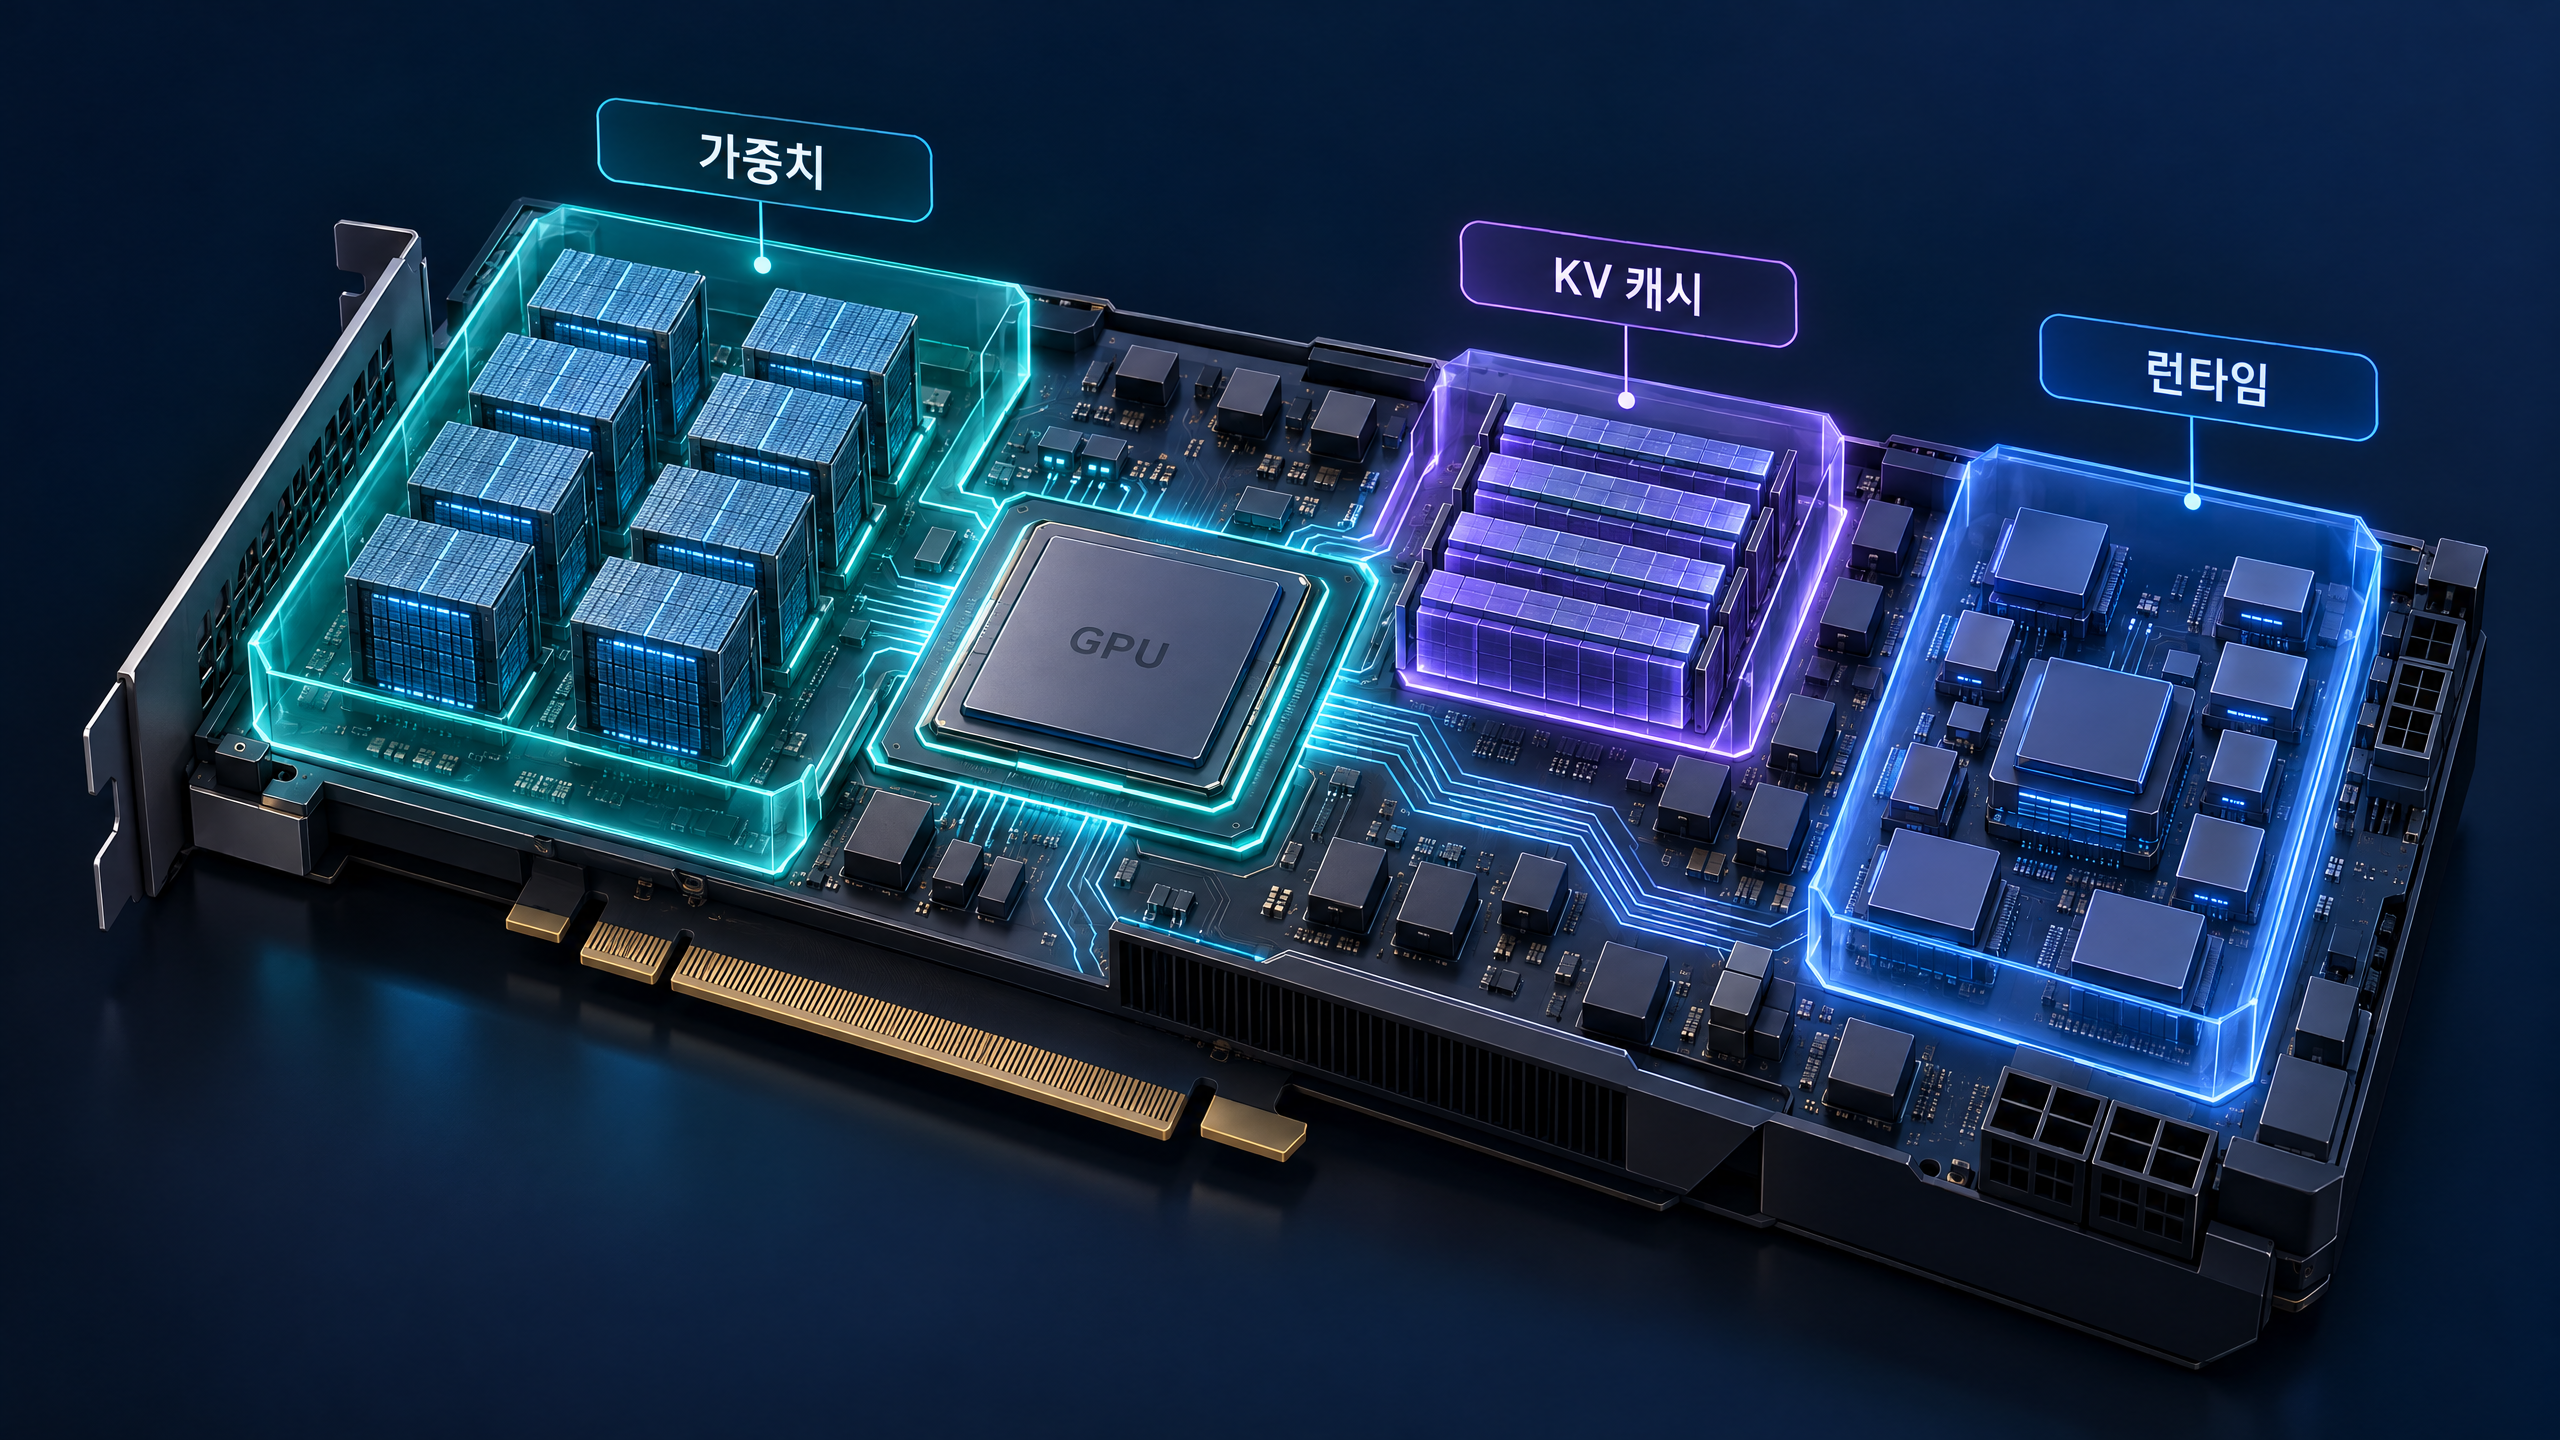
LLM 추론에서는 가중치 외에 활성값, 임시 작업 버퍼, 런타임과 프레임워크의 메모리 등이 필요하다. 대화형 생성에서는 이전 토큰의 키와 값을 보관하는 KV 캐시도 사용한다. 입력과 출력 길이, 배치 크기, 동시 처리 요청이 달라지면 메모리 수요도 달라진다. 긴 문맥을 처리하는 서비스에서는 가중치를 줄인 비율만큼 전체 메모리가 줄지 않을 수 있다.
‘4비트로 저장’과 ‘모든 연산을 4비트로 실행’도 같은 말이 아니다. 가중치만 낮은 비트로 저장하고 계산은 더 높은 정밀도에서 수행하는 구현이 있다. Hugging Face bitsandbytes 문서 역시 4비트 로딩과 계산 정밀도를 별도 설정으로 다룬다. 대상이 아닌 모듈의 정밀도까지 하나의 이름으로 추정해서는 안 된다.
그래서 최소 세 값을 나누어 봐야 한다. 저장된 가중치 크기, 모델을 올린 직후의 메모리, 목표 트래픽을 흘릴 때의 최대 메모리다. 특히 메모리 할당기가 예약한 양과 텐서가 실제로 사용하는 양은 구분해서 기록하는 편이 좋다.
3. 속도 향상과 품질 유지는 자동으로 따라오지 않는다
4비트는 표현할 수 있는 값의 범위를 더 적은 부호로 나타낸다. 이때 생기는 오차를 어떻게 줄이느냐가 중요하다. 같은 4비트라도 INT4와 NF4, 그룹 크기, 보정 방식 등이 다르면 결과가 달라질 수 있다. 요약은 잘하지만 숫자 추출이나 정해진 JSON 형식에서는 품질 차이가 드러나는 상황도 점검해야 한다. 실제 저하 폭은 모델과 작업별 평가 없이 단정할 수 없다.
속도도 마찬가지다. 압축된 가중치를 읽는 이득이 있어도 복원과 스케일 처리에는 비용이 든다. 해당 GPU와 추론 엔진에 효율적인 커널이 있는지에 따라 결과가 달라진다. PyTorch ExecuTorch 양자화 개요도 지원 옵션이 백엔드에 따라 다르다고 설명한다. 다만 모바일·엣지용 문서의 성능을 서버 GPU 결과로 그대로 옮겨서는 안 된다. 공통으로 가져올 원칙은 실제 배포 장치와 소프트웨어 조합을 확인하라는 점이다.
“4비트니까 네 배 빠르다”가 아니라 “이 장치에서 이 형식의 연산이 어떤 경로로 실행되는가”를 물어야 한다. 같은 카드에 들어가더라도 배치를 줄이거나 응답 시간이 늘면 처리 가능한 요청 수가 달라진다.
4. 가상 계산: 가중치는 4분의 1, 전체 메모리는 별개
앞의 가상 100억 파라미터 모델을 다시 보자. 비교를 위해 가중치 외 런타임·작업 공간을 두 경우 모두 3GB, 최대 KV 캐시를 모두 6GB로 고정했다고 가정한다. 이 단순 예시에서 FP16은 20+3+6=29GB, 4비트는 5+3+6=14GB다. 가중치는 4분의 1이지만 전체 합계는 약 절반이다.
이는 실측값이나 특정 모델의 요구 사양이 아니다. 보조 정보와 일부 고정밀 계층 등을 따로 계상하지 않은 설명용 모형이며, 실제로는 런타임·버퍼와 캐시 설정도 달라질 수 있다. 보여주려는 것은 하나다. 줄어들지 않은 항목이 함께 있으면 전체 절감률은 가중치 절감률과 같을 수 없다는 사실이다.
비용도 14GB와 29GB의 비율로 결정되지 않는다. 빌릴 수 있는 GPU의 메모리 구간과 시간당 가격, 필요한 장치 수, 처리량, 응답 목표가 함께 작용한다. 메모리 절약으로 더 작은 GPU를 쓸 수 있는지, 아니면 같은 GPU에서 동시 요청을 더 받을 수 있는지를 따로 확인해야 한다.
5. 도입 전에는 다섯 가지를 같은 조건으로 재보자
- 양자화 범위: 가중치·활성값·KV 캐시 중 무엇을 줄였는지, 높은 정밀도로 남은 계층은 무엇인지 기록한다.
- 메모리: 로딩 직후와 워밍업 후, 목표 입력·출력 길이와 동시성에서의 최대 사용량을 각각 잰다.
- 품질: 원본 모델과 같은 프롬프트 집합으로 한국어 답변, 숫자 정확성, 형식 준수와 긴 문맥 작업을 비교한다. 허용할 저하 폭은 미리 정한다.
- 지원 조합: GPU 아키텍처, 드라이버·CUDA, 엔진과 양자화 라이브러리 버전을 기록하고 해당 형식의 지원 여부를 확인한다.
- 서비스 비용: 워밍업 후 첫 토큰 지연, 전체 응답 시간, 동시 요청 처리량과 오류율을 함께 측정한다. 같은 품질·응답 목표를 충족한 요청당 비용으로 비교한다.
양자화의 경제성은 모델 파일이 얼마나 작아졌는지가 아니라, 같은 품질의 응답을 얼마의 자원으로 처리했는가에서 결정된다. 4비트는 분명 유용한 배포 선택지다. 다만 이름에 붙은 숫자가 계산서의 할인율을 보장하지는 않는다. 먼저 줄어든 항목을 구분하고, 그다음 실제 운영 조건에서 다시 측정해야 한다.